DNS는 무엇이고, 왜 DNS 하나가 서비스 장애로 번질까
쉽게 읽는 IT5분 분량
인터넷의 주소록 DNS가 어떻게 동작하는지 정리하고, 2025년 10월 AWS 장애에서 DNS 기록 하나가 어떤 파장을 냈는지 공개된 사후 보고서로 살펴봅니다.
서비스가 먹통이 되었다는 뉴스에는 종종 DNS라는 단어가 나옵니다. 이 글에서는 DNS가 무엇인지 먼저 쉽게 설명하고, 2025년 10월 AWS 장애를 예로 들어 주소 정보 하나가 잘못되면 왜 여러 서비스가 함께 흔들리는지 살펴봅니다. 장애 내용은 AWS가 공개한 사후 요약을 기준으로 했습니다.
DNS는 인터넷의 주소록입니다
웹사이트 이름(example.com)은 사람이 기억하기 좋게 만든 것이고, 컴퓨터끼리는 숫자로 된 IP 주소로 통신합니다. DNS(Domain Name System)는 이름을 보고 IP 주소를 알려 주는 시스템입니다. 휴대폰 연락처에서 이름을 누르면 전화번호로 걸리는 것과 같습니다.
연락처와 다른 점은 주소록이 한 곳에 있지 않다는 것입니다. 여러 서버가 역할을 나누어 맡습니다. Cloudflare의 설명을 따르면 순서는 대략 이렇습니다.
- 내 기기가 리졸버(recursive resolver)에게 주소를 묻습니다. 보통 통신사나 1.1.1.1, 8.8.8.8 같은 공개 서비스가 이 역할을 합니다.
- 리졸버가 답을 모르면 루트 서버,
.com같은 최상위 도메인(TLD) 서버를 차례로 거칩니다. - 마지막으로 해당 도메인을 관리하는 권한 있는 네임서버가 최종 IP 주소를 알려 줍니다.
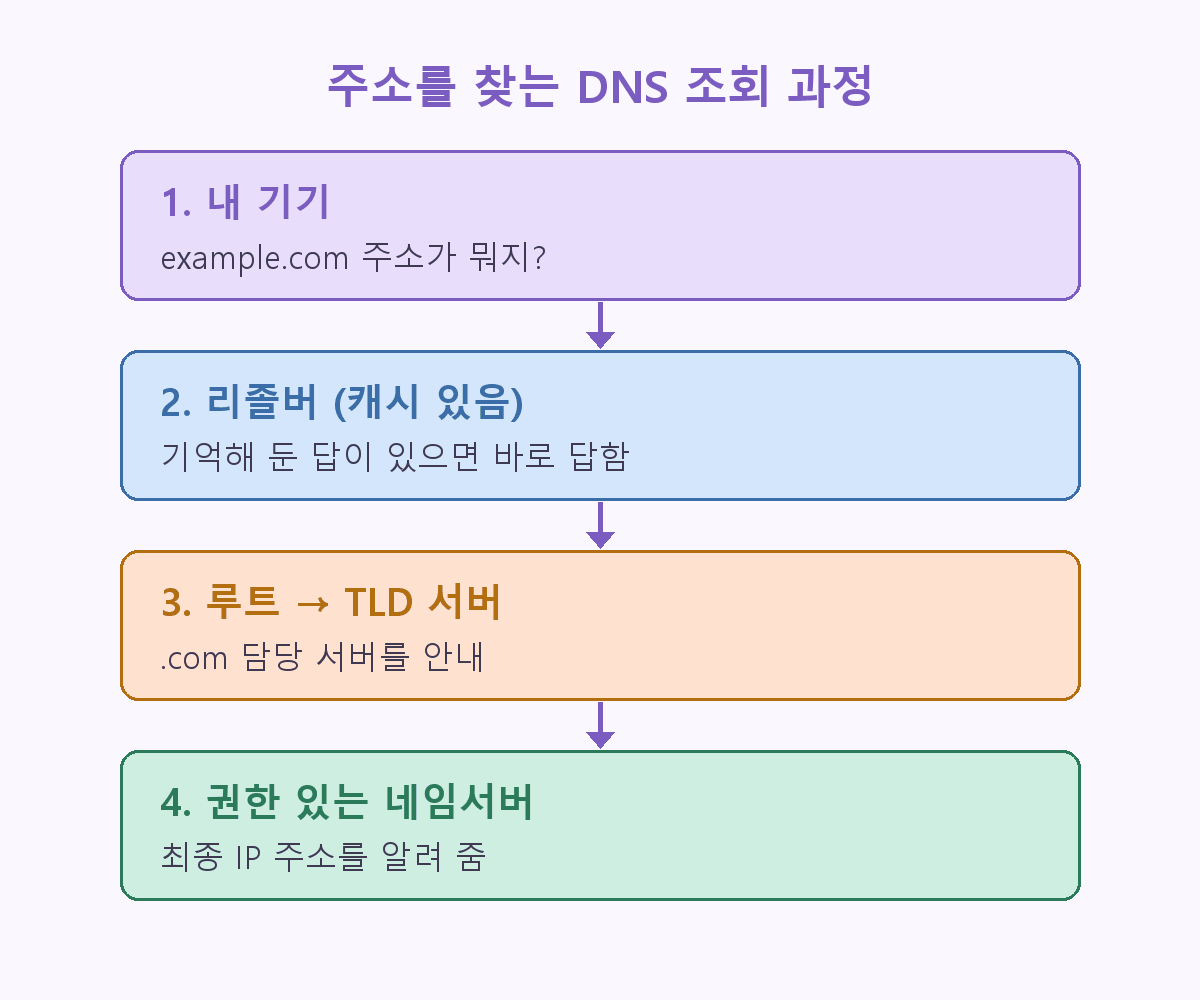
리졸버는 한 번 받은 답을 일정 시간 기억해 둡니다. 이를 캐시라고 합니다. 같은 사이트를 다시 찾을 때 처음부터 묻지 않아도 되니 빠르고, 서버의 부담도 줄어듭니다. 대신 원본이 바뀌어도 캐시가 남아 있는 동안은 예전 답이 쓰일 수 있습니다. 이 성질이 아래 사례에서 다시 나옵니다.
2025년 10월 AWS 장애에서 있었던 일
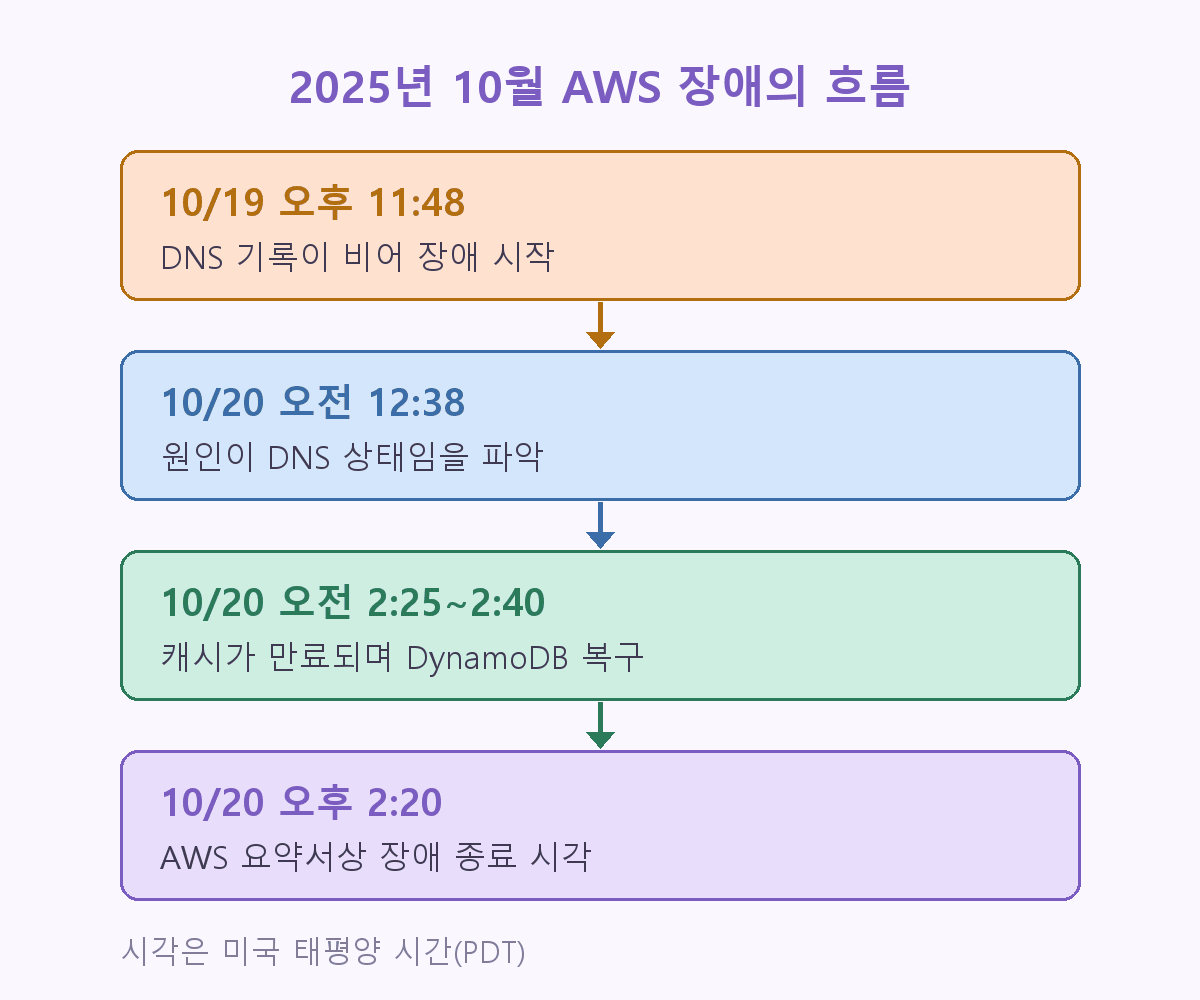
AWS는 2025년 10월 19일~20일 미국 버지니아 북부(us-east-1) 리전에서 발생한 장애에 대해 사후 요약을 공개했습니다. 핵심만 옮기면 다음과 같습니다.
- 장애는 태평양 시간 기준 10월 19일 오후 11시 48분에 시작되었습니다.
- 원인은 DynamoDB(데이터베이스 서비스)의 DNS 관리 자동화 안에 숨어 있던 경쟁 상태(race condition)였습니다. 두 개의 DNS Enactor라는 구성 요소가 같은 기록을 거의 동시에 갱신하려다 맞물렸고, 그 결과 지역 엔드포인트의 DNS 기록이 비어 버렸습니다.
- 자동화가 이 상태를 스스로 고치지 못했습니다.
- AWS 엔지니어는 10월 20일 오전 12시 38분에 DynamoDB의 DNS 상태가 원인임을 파악했습니다.
- 캐시된 기록이 만료되면서 오전 2시 25분~2시 40분 사이에 DynamoDB 주소 조회가 복구되었습니다.
외부 공격이 아니라 내부 자동화의 결함이었다는 점이 눈에 띕니다. AWS의 분석은 사이버 공격이나 DDoS를 원인으로 지목하지 않습니다.
왜 주소 하나가 이렇게 멀리 퍼질까
비유하자면 대형 건물의 안내 데스크가 갑자기 "이 사무실은 어디에도 없습니다"라고 답하는 상황입니다. 사무실 자체는 멀쩡해도 아무도 찾아갈 수 없습니다.
DynamoDB는 AWS 안에서도 다른 서비스가 기대는 기반 부품입니다. 그 주소가 조회되지 않으면 DynamoDB를 쓰는 서비스가 실패하고, 그 서비스에 기대는 다른 서비스도 연쇄적으로 영향을 받습니다. 실제로 AWS 요약에 따르면 DynamoDB 주소 조회가 복구된 뒤에도 EC2와 NLB 같은 서비스는 복구에 더 시간이 걸렸고, AWS Config, Redshift, Connect 등은 밀린 작업을 처리하느라 추가로 몇 시간이 필요했습니다.
그래서 이 장애가 AWS 안에서만 끝나지 않았습니다. 당시 여러 앱과 게임, 금융 서비스가 영향을 받았다고 보도되었습니다. 많은 서비스가 같은 클라우드 위에서 돌아가기 때문입니다.
한 가지 짚어 둘 점이 있습니다. 종료 시각은 자료마다 조금 다릅니다. 상세 요약서는 장애 종료를 오후 2시 20분으로 적었고, 고객 대상 공지에는 오후 3시 1분에 정상화되었다고 되어 있습니다. 이 글에서는 요약서의 시각을 썼습니다.
여기서 읽을 수 있는 점
- DNS는 눈에 잘 띄지 않지만 모든 연결의 첫 단계입니다. 서버가 살아 있어도 주소를 찾지 못하면 서비스는 멈춥니다.
- 자동화는 사람의 실수를 줄여 주지만, 자동화 자체의 드문 결함은 더 큰 파장을 낼 수 있습니다. AWS는 사고 뒤 해당 DNS 자동화(DNS Planner와 DNS Enactor)를 전 세계적으로 비활성화했다고 밝혔습니다.
- 캐시는 양쪽 날을 가집니다. 빠르게 해 주지만, 잘못된 답이 퍼지면 그것이 사라지는 시간도 복구 시간에 포함됩니다.
일반 사용자가 이런 장애를 막을 수는 없습니다. 다만 서비스가 안 될 때 "내 인터넷이 문제인지, 주소 조회가 문제인지, 서비스 쪽 문제인지" 나눠 생각해 볼 수 있다면 뉴스를 읽을 때도 한결 이해가 쉽습니다.
참고한 자료
- #DNS
- #AWS
- #장애
- #인터넷
- #클라우드